Modelos predictivos para priorizar leads
Si tus leads entran por varios canales y los atendés por orden de llegada, estás dejando ventas en la mesa. La idea central es simple: usar datos del CRM y de las conversaciones para decidir a quién contactar primero, cuándo y con qué contexto.
Yo resumiría el tema así:
- Más leads no significa más cierres si el equipo responde tarde o persigue contactos con poca chance.
- La priorización manual se rompe cuando entran leads por WhatsApp, Instagram y web al mismo tiempo.
- Un modelo predictivo no es una planilla con puntos fijos: estima probabilidad de conversión, valor esperado y próximo paso.
- Las señales que más pesan suelen venir del comportamiento y la conversación: página de precios, tiempos de respuesta, presupuesto, urgencia y autoridad.
- Sin datos limpios, el modelo falla: hacen falta etapas consistentes, deduplicación, canales conectados y resultados bien etiquetados.
- Para arrancar, suele servir regresión logística; con más volumen y mejor histórico, pueden rendir mejor modelos como XGBoost o LightGBM; y para chats, suma analizar texto.
- El score no se mira solo: hay que leer probabilidad, confianza y lift.
- Después hay que pasarlo a acción: por ejemplo, score alto = contacto humano en minutos u horas, score medio = nutrición, score bajo = baja prioridad.
- La adopción se cae cuando el equipo no entiende el score, recibe alertas sin protocolo o no puede corregir errores.
- Un despliegue por etapas ayuda: 30 días para validar datos y discriminación, 60 para medir tiempo de respuesta y conversión, 90 para ver cierres y carga de trabajo.
Algunos números del artículo marcan por qué esto importa: el 67% del tiempo de ventas se va en leads que no convierten, y si el primer contacto tarda más de 5 horas, la conversión cae. Además, atender antes del primer contacto puede mejorar la tasa de cierre en 18%.
En otras palabras: no se trata de predecir por predecir. Se trata de ordenar la cola de trabajo para que el equipo venda más y pierda menos tiempo.
Actividad Nº 158 - Predicción de leads con alta probabilidad de conversión.
sbb-itb-3a47d7c
Los datos y variables que hacen útil una predicción
Un modelo predictivo sirve solo si se alimenta con datos integrados, etiquetados y al día. En canales conversacionales, cada chat, cada demora y cada respuesta suman señales en tiempo real. Ahora bien: si tu CRM tiene campos vacíos, leads duplicados o etapas armadas de forma inconsistente, el modelo no aprende nada útil. Aprende ruido.
Resultados de conversión, ajuste al perfil y contexto del negocio
El modelo necesita saber qué pasó con cada lead en el pasado. Por eso conviene definir una variable objetivo bien concreta, como oportunidad creada o negocio cerrado. Cuando el objetivo es difuso, el score se deteriora.
Pero no alcanza con mirar el resultado final. El modelo también necesita contexto del negocio: tamaño de la oportunidad, línea de producto, zona geográfica, tamaño de la empresa, rol del contacto y ajuste al perfil de cliente ideal. Esas variables ayudan a separar a quienes pueden comprar de quienes solo muestran interés.
Sin ese filtro, el modelo puede poner arriba contactos con mucha intención, pero sin presupuesto ni autoridad para decidir. Y ahí aparece el problema: no se trata solo de predecir ventas. Se trata de ordenar la cola de leads según su probabilidad de convertir y su valor esperado.
Cuando el resultado y el contexto están bien definidos, las señales de interacción pasan a pesar mucho más.
Señales de comportamiento, conversación y proceso
Las señales de comportamiento y resúmenes de conversación suelen predecir mejor que los datos de perfil. Visitas a la página de precios, tiempo de respuesta a mensajes, asistencia a reuniones, menciones de presupuesto o de urgencia en el chat: todo eso muestra intención de compra de una forma que un formulario no suele registrar. Estas señales nacen en la conversación, no solo en el CRM.
En operaciones donde WhatsApp es el canal principal, esto importa todavía más. Las señales conversacionales - presupuesto, necesidad, urgencia y autoridad para decidir - están entre los predictores más fuertes de conversión. Y no solo cuenta lo que el lead hace. También cuenta lo que deja de hacer. Si baja la frecuencia de interacción o se alarga el tiempo de respuesta, el modelo tiene que leerlo como una señal.
Lista de verificación antes de construir el modelo
El piso útil está entre 500 y 1.000 leads con resultado conocido (ganado/perdido). Si tenés menos volumen, conviene arrancar con análisis exploratorio antes de modelar.
Antes de avanzar, auditá estas cuatro condiciones mínimas:
- Etapas consistentes: si cada vendedor define "calificado" de una manera distinta, el modelo aprende esa inconsistencia.
- Sin fuga de datos: las variables de predicción tienen que conocerse antes del resultado. Si usás variables que solo existen después, contaminás el modelo.
- Deduplicación: si un mismo contacto aparece dos veces con estados distintos, el algoritmo recibe señales cruzadas que no puede ordenar.
- Canales integrados: si los datos de WhatsApp, formularios web e Instagram viven en sistemas separados, el modelo solo ve una parte del comportamiento real.
Dicho simple: si la calificación no está documentada, el modelo aprende desorden.
Con esas bases recién tiene sentido elegir el modelo y convertir el score en una prioridad operativa.
Qué modelos usar y cómo leer los resultados
Del scoring por reglas al machine learning
No hay un solo modelo que sirva para todos. La elección depende del volumen de leads, la calidad del histórico y qué tan maduro esté el proceso comercial. A partir de ahí, la pregunta deja de ser “qué herramienta está de moda” y pasa a ser qué modelo conviene usar y cómo interpretar lo que devuelve.
Por eso, la primera opción suele ser la regresión logística. Se entiende con facilidad y funciona bien para clasificación binaria - convierte o no convierte - cuando la relación entre variables es más o menos lineal. Si el equipo trabaja con más variables y tiene datos de mejor nivel, los modelos de gradient boosting, como XGBoost o LightGBM, suelen rendir mejor sobre datos tabulares de CRM. ¿La ventaja? Pueden leer relaciones no lineales y bancan mejor los valores faltantes que modelos más simples.
En ventas conversacionales, los modelos de texto (NLP/LLM) suman una capa que los tabulares no ven. Pueden detectar urgencia, objeciones y menciones de presupuesto directo desde conversaciones de WhatsApp, chat y mensajes comerciales. Y además permiten actualizar el score en tiempo real. En un sistema agéntico, esa salida no queda en un número suelto: se transforma en una prioridad que dispara una acción concreta dentro del sistema comercial.
Elegir el modelo, entonces, es apenas el arranque. Lo que pesa de verdad es llevar esa salida a una prioridad de trabajo clara.
| Familia de modelo | Interpretabilidad | Datos necesarios | Patrones no lineales | Señales conversacionales |
|---|---|---|---|---|
| Regresión logística | Alta (coeficientes) | Media (500+ leads) | Baja | Media |
| Árboles de decisión | Alta (flujo visual) | Media | Media | Media |
| Gradient boosting | Media (importancia de variables) | Alta (1.000+ leads) | Alta | Alta |
| Modelos de texto (NLP/LLM) | Media (razonamiento explícito) | Media | Alta | Muy alta |
Cómo leer probabilidad, valor, confianza y lift
Un score no promete un cierre. Es una probabilidad calibrada. Si el modelo está bien calibrado, un score de 80 debería indicar que ese lead tiene unas 4 veces más chances de convertir que el promedio. No quiere decir que vaya a cerrar sí o sí. Esa diferencia parece menor, pero cambia mucho cómo lo usa el equipo: el score no es un semáforo de sí o no.
La confianza del modelo también pesa. Si un caso cae en una zona gris, conviene revisarlo a mano antes de automatizar la decisión. Y si hay una métrica que sirve para mostrar si el modelo está ayudando de verdad, esa es el lift. El lift mide cuánto mejor detecta oportunidades frente a contactar leads al azar o simplemente por orden de llegada. Por ejemplo, si el lift en el primer decil es 3, eso quiere decir que el 10% de leads que el modelo pone arriba junta tres veces más cierres que un 10% elegido al azar.
Patrones en el score que indican un problema
Cuando un modelo falla, casi siempre deja rastros. Y esos rastros suelen verse tanto en los datos como en el proceso comercial.
| Patrón | Causa probable | Acción correctiva |
|---|---|---|
| Score alto, conversión baja | Datos sucios, variable objetivo mal definida, sobreajuste o respuesta lenta | Revisar objetivo, limpiar duplicados, auditar seguimiento |
| Score bajo, cierres de alto valor | Señales de nicho o perfiles atípicos no vistos en entrenamiento | Agregar variables contextuales, habilitar overrides manuales |
| Scores muy parecidos entre sí | Falta de variables discriminantes o desbalance de clases | Enriquecer CRM, revisar desbalance |
| Caída repentina de precisión | Cambio estacional o nuevo tipo de lead por campaña | Reentrenar con datos recientes, monitorear drift |
| Score alto, pero el equipo lo ignora | Falta de transparencia o baja confianza en el modelo | Mostrar factores contribuyentes junto al score |
Si un score alto no termina convirtiendo, antes de cambiar el modelo conviene mirar algo más básico: tiempos de respuesta y calidad del seguimiento. Muchas veces el problema no está en el algoritmo, sino en lo que pasa después.
Con el score ya interpretado, el siguiente paso es llevarlo a colas de atención y acciones concretas para el equipo.
Cómo convertir predicciones en colas de atención y acciones concretas
Con el score, el valor esperado y la confianza ya definidos, el siguiente paso es llevar eso a la operación diaria. O sea: convertir una predicción en una cola de atención y en tareas concretas.
Construir segmentos de contacto a partir de los scores
Un score por sí solo no ordena nada. Lo que ordena la operación es decidir qué hace el equipo en cada rango.
La forma más práctica es separar en tres franjas. Los leads con score mayor a 70 piden contacto humano en menos de 24 horas - si puede ser en minutos, mejor - , porque responder rápido puede aumentar la conversión hasta un 30%. Los que quedan entre 40 y 70 entran en una secuencia automatizada de nutrición. Y los que están por debajo de 40 pasan a baja prioridad o se archivan.
Ahora bien, el segmento final no sale del score aislado. Sale de cruzar score, antigüedad, valor esperado y confianza del modelo. Un lead con score de 65, alto valor esperado y señales claras de urgencia merece más atención que uno con score de 75 recién ingresado y con monto esperado bajo.
Definir la siguiente mejor acción por escenario
Cada segmento necesita un protocolo claro. La lógica es simple: señal + acción.
- Lead nuevo con alta intención (visitó la página de precios, descargó material técnico, score >70): asignación automática al vendedor con mejor tasa de cierre y contacto humano inmediato.
- Lead con buen fit pero objeción de precio: secuencia automatizada con un caso de uso puntual para su industria.
- Lead inactivo que retomó actividad (volvió al sitio o mostró nueva intención): alerta con el contexto de la charla anterior, no un mensaje genérico de reactivación.
Cada alerta tiene que salir con responsable, canal y acción específica. Si no, el equipo recibe ruido en lugar de foco.
Integrar la priorización en el flujo diario de ventas
Los datos se capturan en la conversación, el sistema califica y prioriza, y cada corrección del vendedor alimenta el reentrenamiento. El punto no está en mirar un score suelto, sino en coordinar captura, priorización y acción humana.
En un sistema agéntico, la priorización no se queda quieta en un tablero: dispara acciones. Aurelia usa este esquema como capa de ejecución: Sofi califica, Lucas prioriza, Axel audita y Tobías reactiva leads inactivos. Así, el vendedor recibe el lead ya procesado y con contexto, no un número suelto que tiene que descifrar.
Ese circuito deja de ser un ranking y pasa a ser una cola de trabajo.
| Dimensión | Scoring por reglas | Scoring predictivo | Operación agéntica |
|---|---|---|---|
| Escalabilidad | Media (reglas estáticas) | Alta (análisis automatizado) | Muy alta (agentes autónomos) |
| Uso de datos | Campos fijos del CRM | Histórico + comportamiento | Enriquecimiento en tiempo real |
| Calidad de priorización | Estática por puntos | Por probabilidad de conversión | Por contexto e intención |
| Feedback loop | Actualizaciones manuales | Reentrenamiento periódico | Aprendizaje continuo |
Implementación, adopción y conclusión
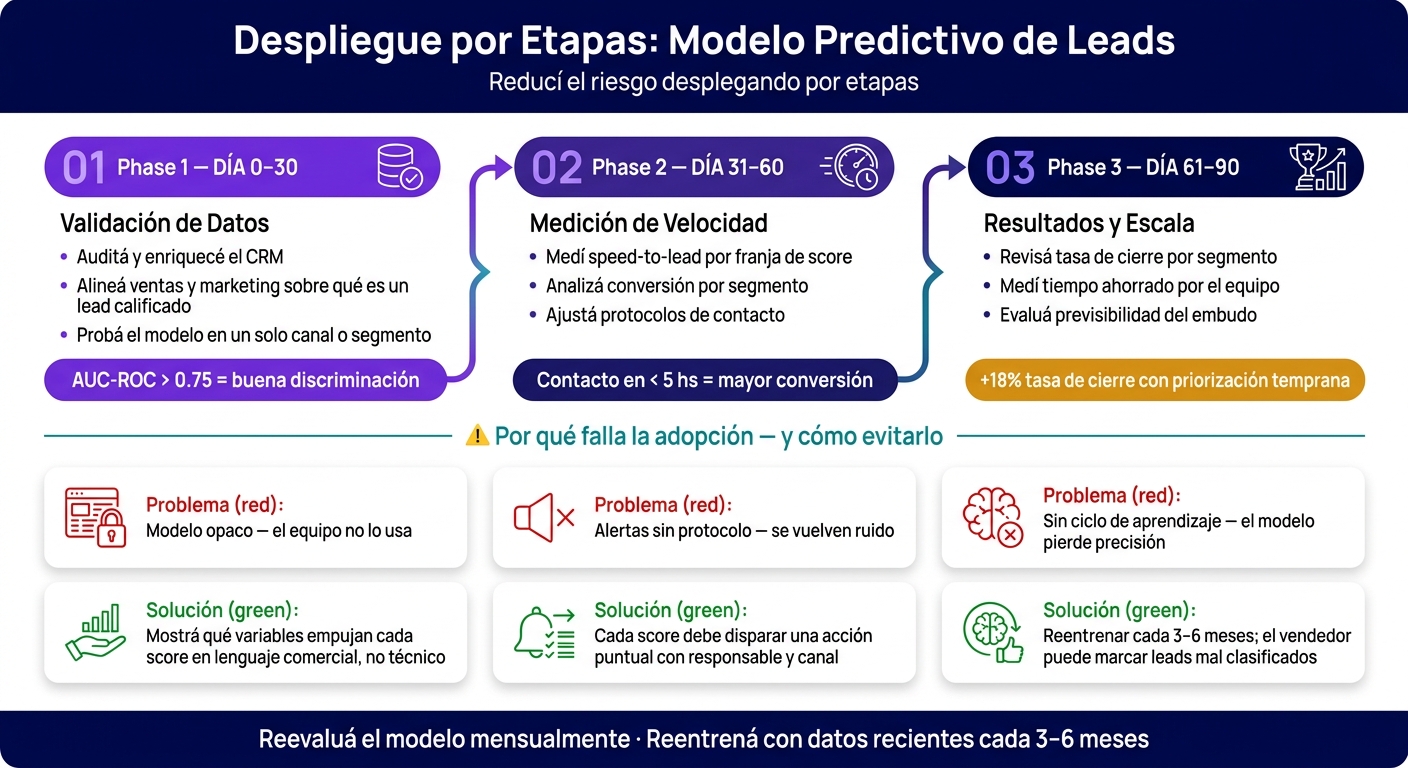
Cómo Implementar un Modelo Predictivo de Leads: Etapas y Métricas Clave
Un despliegue por etapas reduce el riesgo
Con el score ya convertido en una cola de trabajo, el siguiente paso es ponerlo en marcha sin trabar la operación.
Hacerlo por etapas baja el riesgo y le da al equipo tiempo para ganar confianza antes de apoyarse de lleno en el sistema. La secuencia es simple:
- Primero, auditá y enriquecé el CRM.
- Después, alineá a ventas y marketing sobre qué cuenta como un lead calificado para ventas.
- Por último, probá el modelo en un solo canal o segmento.
A los 30 días, validá la calidad del dato y la capacidad de discriminación. Un AUC-ROC por encima de 0,75 muestra que el modelo separa bien los casos convertidos de los que no lo hicieron. A los 60 días, medí speed-to-lead y conversión por franja. A los 90, revisá cierre, tiempo ahorrado y previsibilidad del embudo.
Cuando la priorización ocurre antes del primer contacto, las empresas reportan tasas de cierre un 18 % más altas.
Por qué falla la adopción y cómo evitarla
La adopción suele romperse por tres motivos bastante claros. Y cada uno tiene una salida concreta.
Si el modelo es opaco, el equipo no lo usa. En ese caso, hay que mostrar qué variables empujan cada score en lenguaje comercial, no técnico. Si las alertas llegan sin protocolo, se vuelven ruido. Ahí la salida es que cada score dispare una acción puntual. Y si no existe un ciclo de aprendizaje, el modelo pierde precisión con el paso del tiempo. Para evitarlo, conviene que el vendedor pueda marcar leads mal clasificados y que los perfiles con mejor desempeño participen en la validación.
Además, los modelos tienen que reevaluarse todos los meses y volver a entrenarse con datos recientes cada 3 a 6 meses.
Cuando el equipo entiende la lógica y puede corregir el sistema sobre la marcha, la priorización deja de ser un reporte más y pasa a meterse en la rutina diaria.
Conclusión: puntos clave para priorizar leads con modelos predictivos
La meta no es predecir por predecir. La meta es decidir más rápido quién llama, cuándo y con qué contexto. Para eso hacen falta datos limpios, acuerdo sobre qué es un lead valioso y un piloto que pruebe resultados antes de escalar.
Cuando la predicción se conecta con una cola de leads, velocidad de respuesta y acciones concretas, el equipo deja de perder tiempo en contactos que no van a cerrar. Eso baja la carga operativa, mejora el foco comercial y vuelve más previsible la cartera proyectada.
FAQs
¿Cuándo conviene empezar con un modelo predictivo?
Conviene dar el paso cuando la gestión manual ya te frena.
Pasa, por ejemplo, si entra un flujo constante de leads, si cada persona del equipo dedica más de 4 horas por semana a calificarlos, si cada vendedor usa criterios distintos o si la respuesta llega después de 4 horas. Ahí ya hay una señal clara: el proceso empieza a hacer agua.
También necesitás contar con datos históricos en tu CRM. Sin ese registro, ajustar el criterio y tomar decisiones se vuelve bastante más difícil.
Ahora bien, no siempre vale la pena. Si recibís menos de 20 leads semanales o tenés un proceso muy transaccional, el esfuerzo no se amortiza.
¿Qué hago si mi CRM tiene datos incompletos o duplicados?
Primero, aceptá que la limpieza de datos no es opcional. Un modelo predictivo solo rinde bien si la información es confiable. Si lo entrenás con datos sucios, va a aprender patrones equivocados y te va a devolver resultados poco útiles.
Arrancá con una auditoría simple y después unificá criterios: eliminá duplicados, completá campos vacíos y estandarizá formatos. También asegurate de registrar de manera consistente qué leads convierten y cuáles no. No hace falta buscar perfección desde el día uno. Empezá con datos razonablemente limpios y mejoralos de forma continua.
¿Cómo convierto el score en tareas concretas para ventas?
Convertí el score en una regla de acción dentro del CRM, no en un simple dato para mirar. La idea es simple: cada rango del score tiene que disparar un camino distinto, sin depender de que alguien lo interprete a mano.
- Score alto: ruteo inmediato a un ejecutivo con todo el contexto cargado. El lead tiene que llegar con el briefing listo: fuente, historial, interés, páginas vistas, empresa, cargo y cualquier señal de intención.
- Score medio: entrada a un flujo de nutrición automatizada y posterior recalificación. No conviene mandar a ventas demasiado pronto, pero tampoco dejarlo quieto.
- Score bajo: nutrición de bajo costo o descarte directo, según el caso. Si la señal es floja, no tiene sentido gastar tiempo comercial.
Definí umbrales claros para cada ruta. Por ejemplo, podés trabajar con franjas como 80-100, 50-79 y 0-49, siempre que esos cortes reflejen cómo compra tu mercado y cómo rinde tu embudo.
Después, sumá el score a la ficha del lead en tu CRM para que el sistema no solo lo muestre, sino que asigne la tarea en forma automática. Cuando entre un lead, el ejecutivo debería recibirlo ya preparado, con el briefing armado y los próximos pasos bien claros. Eso evita idas y vueltas y acorta el tiempo de contacto.
También conviene poner una regla de respaldo. Si no hay respuesta en 2 a 4 horas, el lead tiene que pasar a una reasignación automática. Así evitás que una oportunidad buena quede frenada por demora, carga de trabajo o simple descuido.
Y hay una parte que muchos pasan por alto: el modelo no se deja fijo. Después, recalibralo con resultados de cierre. Mirá qué scores terminan en venta, cuáles se enfrían y cuáles nunca avanzan. Con ese feedback, ajustás los pesos, corregís umbrales y hacés que el sistema tome decisiones cada vez mejores.